Ratgeber · 8 Min. Lesezeit
KI-Server für lokale LLMs: Tesla P40, V100, L4 oder A100?
Wie viel Grafikspeicher ein Sprachmodell braucht, welche Rechenzentrums-GPU zu welchem Budget passt und worauf es bei Kühlung, Strom und Software ankommt.
Lagerware verlässt unser Lager in Deutschland innerhalb von 24 Stunden
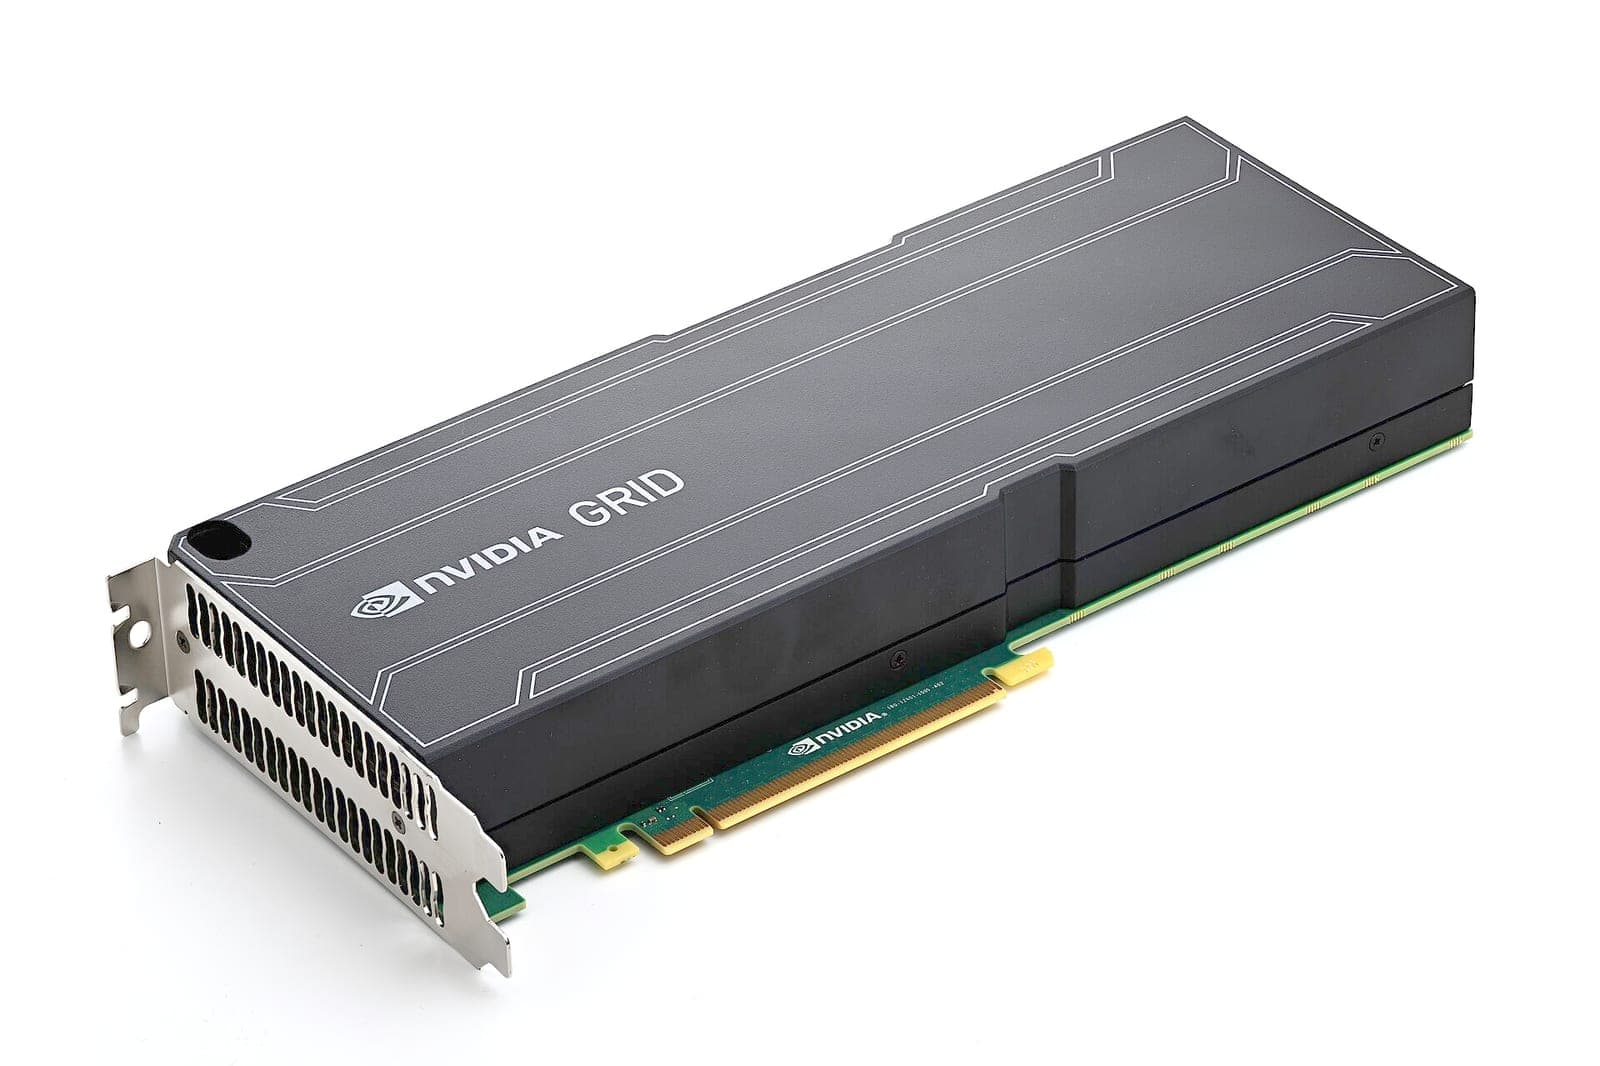
Server-GPUs und KI-Beschleuniger von NVIDIA beschleunigen Inferenz und Training von KI-Modellen, wissenschaftliche Berechnungen, Rendering, virtuelle Desktops und Videotranskodierung. Das Sortiment reicht von der günstigen Tesla P40 mit 24 GB über die sparsamen Low-Profile-Karten T4 und L4 bis zur A100 mit 80 GB HBM2e. Wichtig vor dem Kauf: Die meisten Datacenter-Karten sind passiv gekühlt und benötigen den gerichteten Luftstrom eines Servers; in Workstations ist zusätzliche Kühlung nötig. Viele Modelle werden über einen 8-Pin-CPU-Anschluss (EPS-12V) statt PCIe 8-Pin versorgt, Doppel-Slot-Karten brauchen einen freien Steckplatz in voller Höhe und Länge (FHFL). Gebrauchte Karten werden gereinigt, geprüft und getestet. Die Garantie beträgt 12 bis 36 Monate.
Keine Produkte gefunden
Passen Sie die Filter an oder fragen Sie uns direkt – vieles beschaffen wir innerhalb weniger Tage.
Von der NVIDIA A100 mit 80 GB HBM2e bis zur Tesla P40 als günstigem 24-GB-Einstieg: Server-GPUs unterscheiden sich weniger in der reinen Rechenleistung als in Speichergröße, Bandbreite, Bauform und Leistungsaufnahme. Die Übersicht und die folgenden Abschnitte zeigen, welche Karte in welchen Server passt und wofür sie sich eignet.
| GPU | Generation | Speicher | Bandbreite | TDP | Bauform |
|---|---|---|---|---|---|
| Tesla P40 | Pascal | 24 GB GDDR5 | 346 GB/s | 250 W | Dual-Slot FHFL, passiv |
| Tesla T4 | Turing | 16 GB GDDR6 | 320 GB/s | 70 W | Single-Slot Low Profile, passiv |
| Tesla V100 | Volta | 16 GB HBM2 | 900 GB/s | 250 W | Dual-Slot FHFL, passiv |
| L4 | Ada Lovelace | 24 GB GDDR6 | 300 GB/s | 72 W | Single-Slot Low Profile, passiv |
| A40 | Ampere | 48 GB GDDR6 mit ECC | 696 GB/s | 300 W | Dual-Slot FHFL, passiv |
| RTX A6000 | Ampere | 48 GB GDDR6 mit ECC |
| 768 GB/s |
| 300 W |
| Dual-Slot FHFL, aktiv |
| A100 40 GB | Ampere | 40 GB HBM2 | 1.555 GB/s | 250 W | Dual-Slot FHFL, passiv |
|---|
| A100 80 GB | Ampere | 80 GB HBM2e | 1.935 GB/s | 300 W | Dual-Slot FHFL, passiv |
|---|
Die A100 spielt ihre Stärke aus, wenn Speichergröße und Bandbreite begrenzen: Ein Sprachmodell erzeugt Token im Wesentlichen so schnell, wie die GPU seine Gewichte aus dem Speicher liest. Die 80-GB-Version liefert dafür fast dreimal so viel Bandbreite wie eine A40. Für Training unterstützt sie TF32 und BF16, und neben der V100 ist sie die einzige Karte der Liste, die schnell in doppelter Genauigkeit (FP64) für Simulationen rechnet.
Mit Multi-Instance GPU (MIG) teilen Sie eine A100 in bis zu sieben isolierte Instanzen, bei der 80-GB-Karte mit je 10 GB. Zwei Karten lassen sich per NVLink-Bridge koppeln. Die A100 ist für PCIe 4.0 gebaut; in PCIe-3.0-Servern läuft sie, lädt Daten aber langsamer nach. Passende Systeme finden Sie unter GPU-Server.
Pascal und Volta werden von aktuellen CUDA-12-Versionen unterstützt, neuere CUDA-Hauptversionen setzen jedoch jüngere Generationen voraus. Für Projekte mit langer Laufzeit sind Turing, Ampere und Ada die sicherere Wahl.
Die L4 folgt auf die T4: gleiche Low-Profile-Bauform, aber 24 statt 16 GB, FP8-Tensor-Kerne und ein AV1-Encoder bei nur 72 W. Sie läuft auch in PCIe-3.0-Servern und ist damit der einfachste Weg, einen vorhandenen Rack-Server KI-fähig zu machen.
Die RTX A6000 ist aktiv gekühlt und damit die einzige Karte der Liste, die ohne Server-Luftstrom in einer Workstation arbeitet. Ihr passives Gegenstück für Server ist die A40 mit ebenfalls 48 GB. Sie ist zusätzlich für vGPU ausgelegt, wofür NVIDIA eine eigene Softwarelizenz verlangt; die Bedingungen prüfen Sie am besten direkt beim Hersteller.
Welche Karte für welches Sprachmodell reicht, rechnet der Ratgeber KI-Server für lokale LLMs durch. Ausgemusterte Karten kaufen wir über den Ankauf an.
Entscheidend ist der Grafikspeicher. 24 GB (P40, L4) reichen für Modelle bis etwa 30 Milliarden Parameter in 4-Bit-Quantisierung, 48 GB (A40, RTX A6000) für 70B-Modelle. vLLM setzt mindestens Compute Capability 7.0 voraus und läuft damit ab der V100, nicht auf der P40; llama.cpp und Ollama unterstützen auch die P40.
Nur mit zusätzlicher Kühlung, etwa einem Lüfteraufsatz, der Luft direkt durch den Kühlkörper drückt. Ohne gerichteten Luftstrom drosseln passive Karten nach kurzer Zeit oder schalten ab. Die aktiv gekühlte RTX A6000 ist dagegen für Workstations ausgelegt.
Tesla P40, V100, A100, A40 und RTX A6000 haben einen 8-Pin-CPU-Anschluss (EPS-12V). Im Server wird das GPU-Kabel des Serverherstellers verwendet, in Workstations ein Adapter von zwei PCIe-8-Pin-Steckern auf 8-Pin-EPS. T4 und L4 werden allein über den PCIe-Steckplatz versorgt.
Ratgeber · 8 Min. Lesezeit
Wie viel Grafikspeicher ein Sprachmodell braucht, welche Rechenzentrums-GPU zu welchem Budget passt und worauf es bei Kühlung, Strom und Software ankommt.