KI-Server für lokale LLMs: Tesla P40, V100, L4 oder A100?
Wie viel Grafikspeicher ein Sprachmodell braucht, welche Rechenzentrums-GPU zu welchem Budget passt und worauf es bei Kühlung, Strom und Software ankommt.
- Veröffentlicht
- Aktualisiert
- Lesezeit
- 8 Min.
- Thema
- KI & Homelab
Inhalt10 Abschnitte
- Warum der VRAM beim KI-Server die Grenze setzt
- Wie viel VRAM braucht ein LLM?
- GPUs im Vergleich: von Tesla P40 bis A100
- Kühlung, Stromanschluss und Netzteil
- PCIe-Slots, Riser und mehrere GPUs
- Software für den LLM-Server: Ollama, llama.cpp und vLLM
- Den passenden GPU-Server auswählen
- Strom und Kühlung im Dauerbetrieb
- Datenschutz: Warum ein lokaler LLM-Server?
- Häufige Fragen
Das Wichtigste in Kürze
- VRAM entscheidet: Ein 4-Bit-Modell braucht rund 0,5–0,7 GB pro Milliarde Parameter plus Reserve für den Kontext – ein 70B-Modell also 45–55 GB.
- Bandbreite bestimmt das Tempo: Wie schnell Text entsteht, hängt vor allem davon ab, wie schnell die GPU ihren Speicher liest.
- Passive Datacenter-GPUs wie P40, T4, L4, A40 und A100 brauchen den Luftstrom eines Servers, die großen Karten zusätzlich 8-Pin-EPS-Strom.
- Langfristig sprechen Treiber- und CUDA-Unterstützung für Turing, Ampere und Ada statt Pascal und Volta.
Ein KI-Server für lokale Sprachmodelle ist im Kern ein normaler Server mit einer oder mehreren GPUs. Ob er taugt, entscheiden drei Dinge: wie viel Grafikspeicher (VRAM) die Karten haben, wie schnell dieser Speicher ist und ob Gehäuse, Netzteile und Lüfter die Karten dauerhaft versorgen.
Warum der VRAM beim KI-Server die Grenze setzt
Für jedes erzeugte Token liest die GPU alle Gewichte des Modells einmal aus dem Speicher. Das Tempo der Textausgabe hängt deshalb vor allem an der Speicherbandbreite: Bandbreite geteilt durch Modellgröße ergibt die Obergrenze. Ein 4-Bit-Modell mit 20 GB schafft auf einer Tesla P40 (346 GB/s) rechnerisch höchstens rund 17 Token pro Sekunde, auf einer RTX A6000 (768 GB/s) etwa 38.
Passt das Modell nicht ganz in den VRAM, lagern Ollama und llama.cpp Schichten in den Arbeitsspeicher aus – und das Tempo bricht ein. Tensor-Kerne und Rechenleistung zählen vor allem beim Einlesen langer Prompts und bei vielen gleichzeitigen Nutzern.
Wie viel VRAM braucht ein LLM?
Für quantisierte Modelle gilt eine einfache Faustregel: Bei 4 Bit belegen die Gewichte rund 0,5–0,7 GB pro Milliarde Parameter. Dazu kommen der KV-Cache für den Kontext, also das Gedächtnis des Gesprächs, und etwa 0,5–1 GB für die Laufzeitumgebung. 8 Bit braucht etwa doppelt so viel, FP16 rund viermal so viel.
| Modellgröße | Gewichte bei 4 Bit | Mit Kontext (Richtwert) | Passt z. B. auf |
|---|---|---|---|
| 7–8B | 3,5–5,5 GB | 6–8 GB | T4, L4, V100 16 GB |
| 13–14B | 6,5–10 GB | 10–13 GB | T4 und V100 (knapp), L4, P40 |
| 30–34B | 16–24 GB | 20–28 GB | P40 oder L4 mit kurzem Kontext, A40, RTX A6000 |
| 70B | 35–49 GB | 42–55 GB | A40 oder RTX A6000 (knapp), 2 × 48 GB, A100 80 GB |
GPUs im Vergleich: von Tesla P40 bis A100
Die Karten aus unserer Kategorie Server-GPUs im Überblick. FHFL steht für volle Höhe und Länge, LP für Low Profile.
| GPU | Architektur | VRAM und Bandbreite | TDP | Bauform und Strom |
|---|---|---|---|---|
| Tesla P40 | Pascal | 24 GB GDDR5, 346 GB/s | 250 W | FHFL, passiv, 8-Pin-EPS |
| Tesla T4 | Turing | 16 GB GDDR6, 320 GB/s | 70 W | LP, passiv, kein Zusatzstrom |
| Tesla V100 16 GB PCIe | Volta | 16 GB HBM2, 900 GB/s | 250 W | FHFL, passiv, 8-Pin-EPS |
| NVIDIA L4 | Ada Lovelace | 24 GB GDDR6, 300 GB/s | 72 W | LP, passiv, kein Zusatzstrom |
| RTX A6000 | Ampere | 48 GB GDDR6 ECC, 768 GB/s | 300 W | FHFL, aktiver Lüfter, 8-Pin-EPS |
| A40 | Ampere | 48 GB GDDR6 ECC, 696 GB/s | 300 W | FHFL, passiv, 8-Pin-EPS |
| A100 PCIe | Ampere | 40 GB HBM2 (1.555 GB/s) oder 80 GB HBM2e (1.935 GB/s) | 250 / 300 W | FHFL, passiv, 8-Pin-EPS |
Die Tesla P40 ist der günstigste Weg zu 24 GB, hat aber keine Tensor-Kerne und kaum FP16-Leistung; llama.cpp kommt trotzdem gut mit ihr zurecht. Tesla T4 und NVIDIA L4 brauchen kein Stromkabel, die L4 bietet dazu 24 GB und FP8. Die schnelle Tesla V100 eignet sich für 7–14B-Modelle. A40 und RTX A6000 bieten 48 GB. Die NVIDIA A100 mit MIG spielt ihre Stärken bei vielen Nutzern und beim Fine-Tuning aus.
Kühlung, Stromanschluss und Netzteil
Passive Karten brauchen Server-Luftstrom
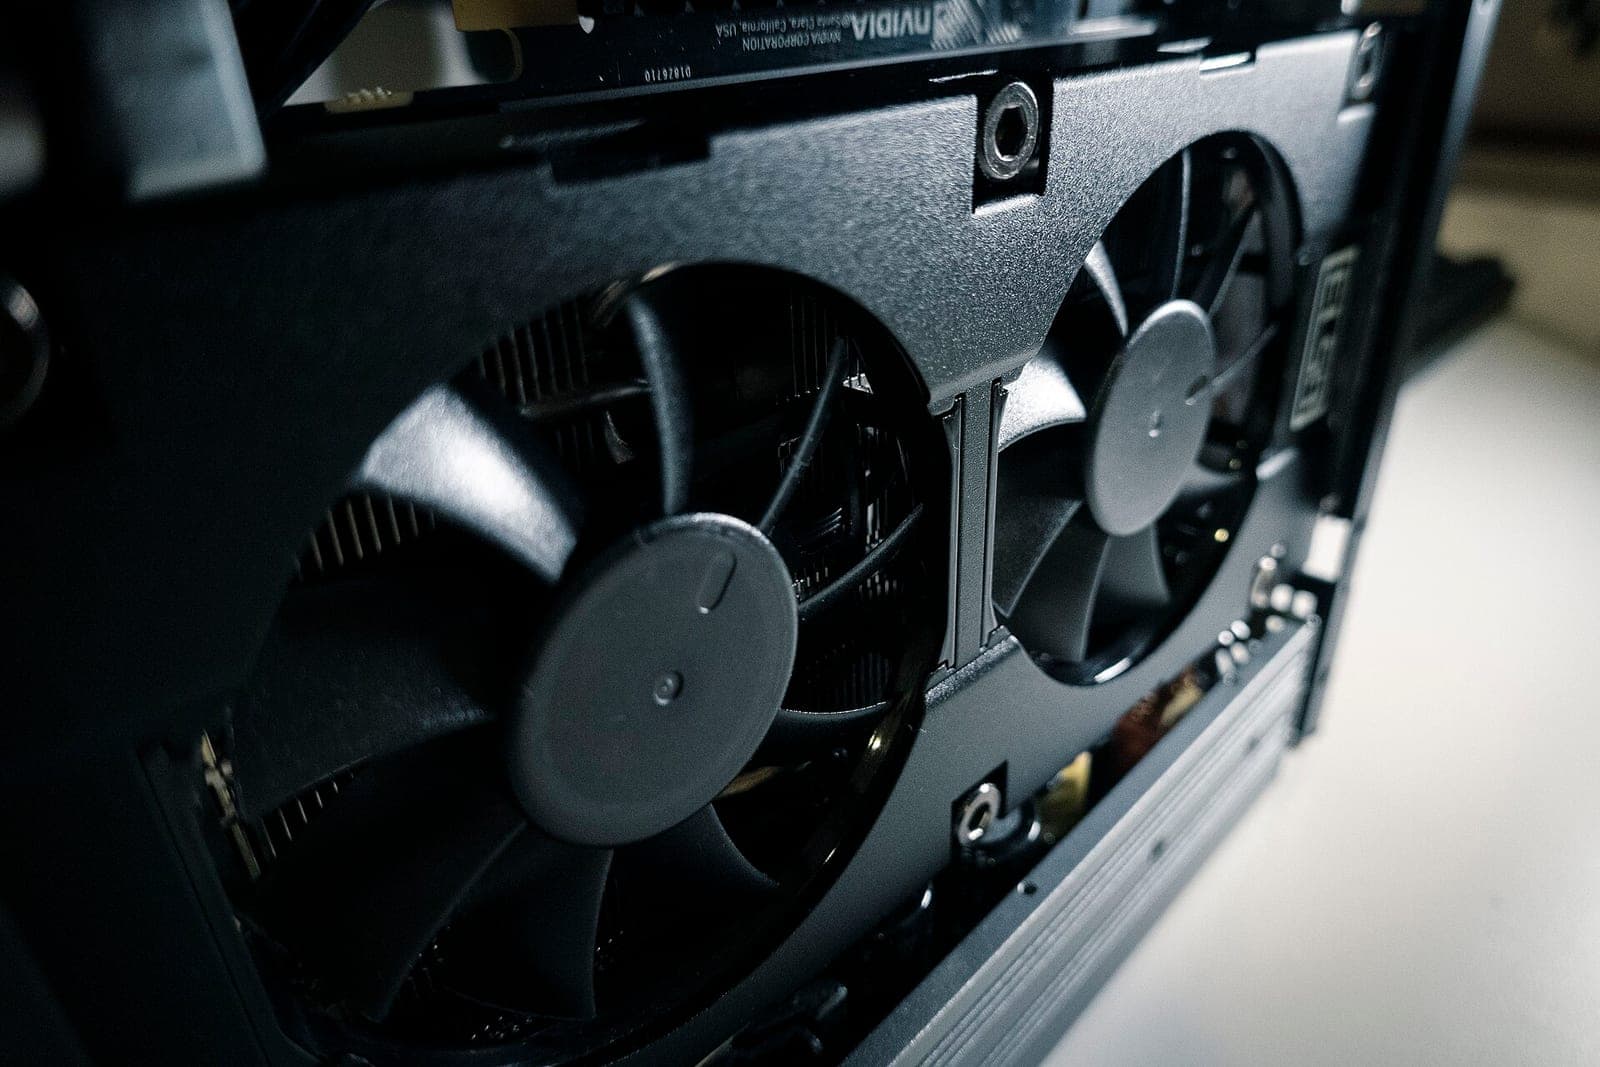
P40, T4, V100, L4, A40 und A100 haben keine eigenen Lüfter. Die Gehäuselüfter des Servers müssen die Luft durch ihre Kühlkörper drücken. In einem Tower-PC ohne gerichteten Luftstrom überhitzen sie und drosseln den Takt – auch die kleine T4. Nur die RTX A6000 bringt einen eigenen Radiallüfter mit.
Stromanschluss: EPS statt PCIe
Die großen Datacenter-Karten werden über einen 8-Pin-EPS-Anschluss versorgt, wie ihn auch CPUs nutzen – nicht über den 8-Pin-PCIe-Stecker von Gaming-Karten. T4 und L4 kommen mit den 75 W aus dem Slot aus.
Netzteil richtig dimensionieren
Addieren Sie die TDP aller GPUs und CPUs, rechnen Sie 150–250 W für RAM, Laufwerke und Lüfter dazu und schlagen Sie 20–30 % Reserve auf. Beispiel Dell R740 mit 2× Tesla V100: 2 × 250 W + 2 × 125 W + 200 W = 950 W, mit Reserve gut 1.200 W. Bei redundanten Netzteilen muss jedes einzelne diese Last allein tragen.
PCIe-Slots, Riser und mehrere GPUs
Jede GPU sollte in einem Slot mit 16 Lanes sitzen; für Inferenz mit wenigen Nutzern genügen auch 8, weil das Modell nur einmal geladen wird. Doppelt breite Karten brauchen in Rack-Servern den passenden GPU-Riser und oft ein Kit aus Stromkabeln und Luftführung. Ein 2U-Server wie der Dell R740 nimmt bis zu drei solcher Karten auf, spezialisierte GPU-Server bis zu acht.
Schichten verteilen oder Tensor-Parallelität
Ollama und llama.cpp verteilen die Schichten eines Modells auf mehrere Karten: Der VRAM addiert sich, das Tempo kaum, weil die Karten nacheinander arbeiten. vLLM teilt per Tensor-Parallelität jede Schicht auf 2, 4 oder 8 gleiche Karten auf, die gleichzeitig rechnen. NVLink bieten hier nur A100, A40 und RTX A6000, per Brücke für je zwei Karten; P40, T4, L4 und V100 PCIe nutzen PCIe.
Software für den LLM-Server: Ollama, llama.cpp und vLLM
Ollama ist der einfachste Weg zum eigenen Ollama-Server: Es lädt Modelle herunter und stellt sie über eine HTTP-API bereit; technisch nutzt es die Bibliotheken von llama.cpp. llama.cpp selbst bietet mehr Kontrolle über Quantisierung, Kontext und Aufteilung auf GPU und CPU und läuft auch auf der P40. vLLM ist für viele gleichzeitige Anfragen gebaut, reserviert standardmäßig den größten Teil des VRAM und setzt Tensor-Kern-GPUs voraus; die unterstützten Architekturen nennt die Dokumentation der jeweiligen Version.
Als VM unter Proxmox VE bekommt der KI-Server die GPU per PCIe-Passthrough; die Plattform stellt der Ratgeber Proxmox statt VMware vor. Planen Sie mindestens so viel Arbeitsspeicher ein, wie die Modelldateien groß sind.
Treiber und CUDA: auf die Architektur achten
Den passenden GPU-Server auswählen
Ob Sie einen KI-Server selber bauen oder ein bestücktes System nehmen: Die passende Ausbaustufe hängt von Modellgröße, Nutzerzahl und Standort ab.
Einstieg
2U-Server mit 1–2 Low-Profile-Karten
- T4 oder L4 mit rund 70 W, ohne Zusatzstrom
- passt in viele vorhandene Server
- 16–48 GB VRAM insgesamt
- große Modelle laufen langsam
Geeignet für: Ideal für 7–14B-Modelle, Tests und kleine Teams.
Mittelklasse
2U-Server mit zwei großen Karten
- 32–96 GB VRAM mit Tensor-Kernen
- 70B-Modelle auf zwei 48-GB-Karten
- 250–300 W pro Karte
- unter Last laut, gehört ins Rack
Geeignet für: Ideal für Abteilungen und Dokumentensuche (RAG).
Oberklasse
GPU-Server mit 4–8 Karten
- bis zu 8 × 80 GB VRAM mit A100
- Tensor-Parallelität und Fine-Tuning
- mehrere Kilowatt unter Last
- eigener Stromkreis und Klimatisierung nötig
Geeignet für: Ideal für viele gleichzeitige Nutzer und große Modelle.
Für die Oberklasse führen wir den Supermicro SYS-4029GP-TRT für acht doppelt breite Karten in 4U und den Gigabyte G292-Z20 mit acht Karten in 2U, AMD EPYC und PCIe 4.0. Alle Systeme finden Sie unter GPU-Server; für den Einstieg reicht oft ein vorhandener 2U-Server mit einer Tesla T4 oder L4.
Strom und Kühlung im Dauerbetrieb
Jedes Watt der GPUs wird zu Wärme. Ein Server mit zwei großen Karten zieht im Leerlauf 150–250 W, unter Last 800 W und mehr. Bei angenommen 30 ct/kWh kosten 200 W Dauerlast 200 W × 8.760 h = 1.752 kWh, also rund 526 € im Jahr. Ein 8-GPU-Server mit 3 kW unter Last reizt einen normalen 16-A-Stromkreis (3,7 kW) fast aus und gehört in ein klimatisiertes Rack mit eigener Absicherung.
GPU-Server sind unter Last laut. Leisere Alternativen fürs Arbeitszimmer zeigt der Ratgeber Homelab-Server, Einbau und Stromverteilung im Schrank erklärt der Ratgeber 19-Zoll-Rack.
Datenschutz: Warum ein lokaler LLM-Server?
Der häufigste Grund für einen eigenen LLM-Server ist die Kontrolle über die Daten: Verträge, Kundendaten oder Quellcode verlassen das eigene Netz nicht, kein externer KI-Anbieter verarbeitet sie. Das vereinfacht die Bewertung nach DSGVO, ersetzt aber nicht die Prüfung durch Ihren Datenschutzbeauftragten. Bei offenen Modellen sollten Sie vor dem gewerblichen Einsatz die Lizenz prüfen.
Häufige Fragen
Kurze Antworten auf die Fragen, die zu diesem Thema am häufigsten kommen.
Wie viel VRAM braucht ein 70B-Modell?
In 4 Bit belegen die Gewichte rund 35–49 GB, mit Kontext sollten Sie 45–55 GB rechnen. Das passt knapp auf eine 48-GB-Karte wie A40 oder RTX A6000, bequem auf zwei davon oder auf eine A100 mit 80 GB.
Ist die Tesla P40 noch für LLMs geeignet?
Für den Einstieg mit llama.cpp oder Ollama ja, 24 GB VRAM gibt es kaum günstiger. Die Karte hat aber keine Tensor-Kerne und wird von neuen CUDA-Hauptversionen nicht mehr unterstützt. Für vLLM und langfristige Projekte passen L4, A40 oder A100 besser.
Läuft ein Ollama-Server auch ohne GPU?
Ja, Ollama läuft auch nur auf der CPU. Das Tempo hängt dann von der Bandbreite des Arbeitsspeichers ab: Kleine Modelle laufen auf einem Server mit sechs oder acht Speicherkanälen brauchbar, ein 70B-Modell liefert nur wenige Token pro Sekunde.
Was ist der Unterschied zwischen NVIDIA L4 und Tesla T4?
Beide sind Low-Profile-Karten mit rund 70 W ohne Zusatzstrom. Die L4 basiert auf der neueren Ada-Architektur, hat 24 statt 16 GB VRAM und unterstützt FP8 und PCIe 4.0. Die T4 ist günstiger und reicht für Modelle bis etwa 14B.
Weiterlesen
Homelab-Server für zuhause: leise, sparsam, gebraucht
MicroServer, Tower oder Rack? So finden Sie einen gebrauchten Server, der leise genug fürs Arbeitszimmer ist, wenig Strom braucht und trotzdem Platz für VMs und Platten bietet.
Weiterlesen
Gebrauchte Server kaufen: Worauf es wirklich ankommt
Generation, Bauform, CPU, RAM, Controller, Fernwartung und Garantie: Diese Punkte entscheiden, ob ein gebrauchter Server zu Ihrer Aufgabe passt.
Weiterlesen
RAID 10, RAID 5 oder RAID 6? RAID-Level im Vergleich
Von RAID 0 bis RAID 60: was jedes Level an Kapazität, Sicherheit und Schreibleistung bringt, warum große Festplatten RAID 6 brauchen und wann ein HBA besser passt.
Weiterlesen